爱吱声

标题: DeepSeek R1全参数模型一个可能的本地部署方案 [打印本页]

作者: 沉宝    时间: 2025-2-20 15:41
标题: DeepSeek R1全参数模型一个可能的本地部署方案
DeepSeek一夜爆火,现在联网服务拥堵不堪。当晨老大号召自建farm的时候,本人开始认真考虑本地部署。 KTransfomer的报道也在第一时间见到,并设想了一个以此为基础的装机方案。然后呢,就“铲后抑郁”了。如今很多内容都在网友[大黑蚊子]的记录(链接)中讨论过了,但具体的装机方案大概还有一些价值,还是写出来吧。
& ?5 d- o0 p& X& x  e+ b- J+ _/ Q/ f1 H6 H: }5 S
DeepSeek R1原版是一个参数量高达671B的大模型,虽然比之其它頂尖的人工智能模型在硬件要求上已经大大降低,但个人部署全尺寸模型,依然难度不小。为了便于在低端硬件上运行,出现了一系列蒸馏版减少参数量(以 Qwen2.5 或 Llama 为构架,参数范围从 1.5B、7B、8B、14B、32B 到 70B)。另一个思路是参数量化,例如1.58bit和4bit。一般来说,LLM训练时使用高精度(例如 32位浮点数),而推理时使用低精度(16位浮点数或者更低)即可。1.58bit是把这一趋势推到极端(只有0、1和-1三种状态)。有人试验了DeepSeek全尺寸模型的1.58bit的量化版,结论基本可用,有时候说话可能有点“冲”,圆润平衡上差一些。4bit版效果已经相当好了。至于[xiejin77]担忧的量化影响反馈精度或者稳定性,理论上有可能,但实际影响需要大量的对比实验加以证实或者证伪。# u, b* e5 O) H3 f( u0 W
& {0 w% l/ P6 C/ Z8 f
下面讨论具体装机方案。首先定一下目标。目标用户:个人或者小团体。鉴于这个模型现在典型的应用场景都是文字的输入和输出,跨网络合用的难度并不大(因为不需要占据太多的网络带宽)。单机,预算定位$5000左右。应该属于一个人咬咬牙能冲得上去,小范围集资(10人以内的那种)能够轻易支付。目标性能:DeepSeek R1全尺寸671B的4bit量化版,输出速度与人的阅读速度差不多即可(个人使用,太快了没有必要),约 5-10 tokens/s。这样的预算,这样的目标,显然需要KTransfomer技术加成才有可能达到。饶是如此,也得按市场最低价加DIY省着来。
  Y+ C% P( O4 Y+ }
/ E2 a/ ~! u  @  p4 q" U7 z$ o2 e第一步:内存的大小。将模型的参数全部放入内存是必须的。如果还用硬盘空间扩展出来的虚拟内存,那速度肯定慢的不行。DeepSeek参数精度16bit(BF16)时需要 1342GB的存储空间,4bit量化版所需空间为其¼,再加上程序和操作系统所需,512GB应该可以了。这么大的内存,普通PC机主板肯定不行,要上服务器的。鉴于当前DDR4的内存条比 DDR5还是要便宜不少,所以选择DDR4。
( f/ q8 b) c% H- T* g2 {, g
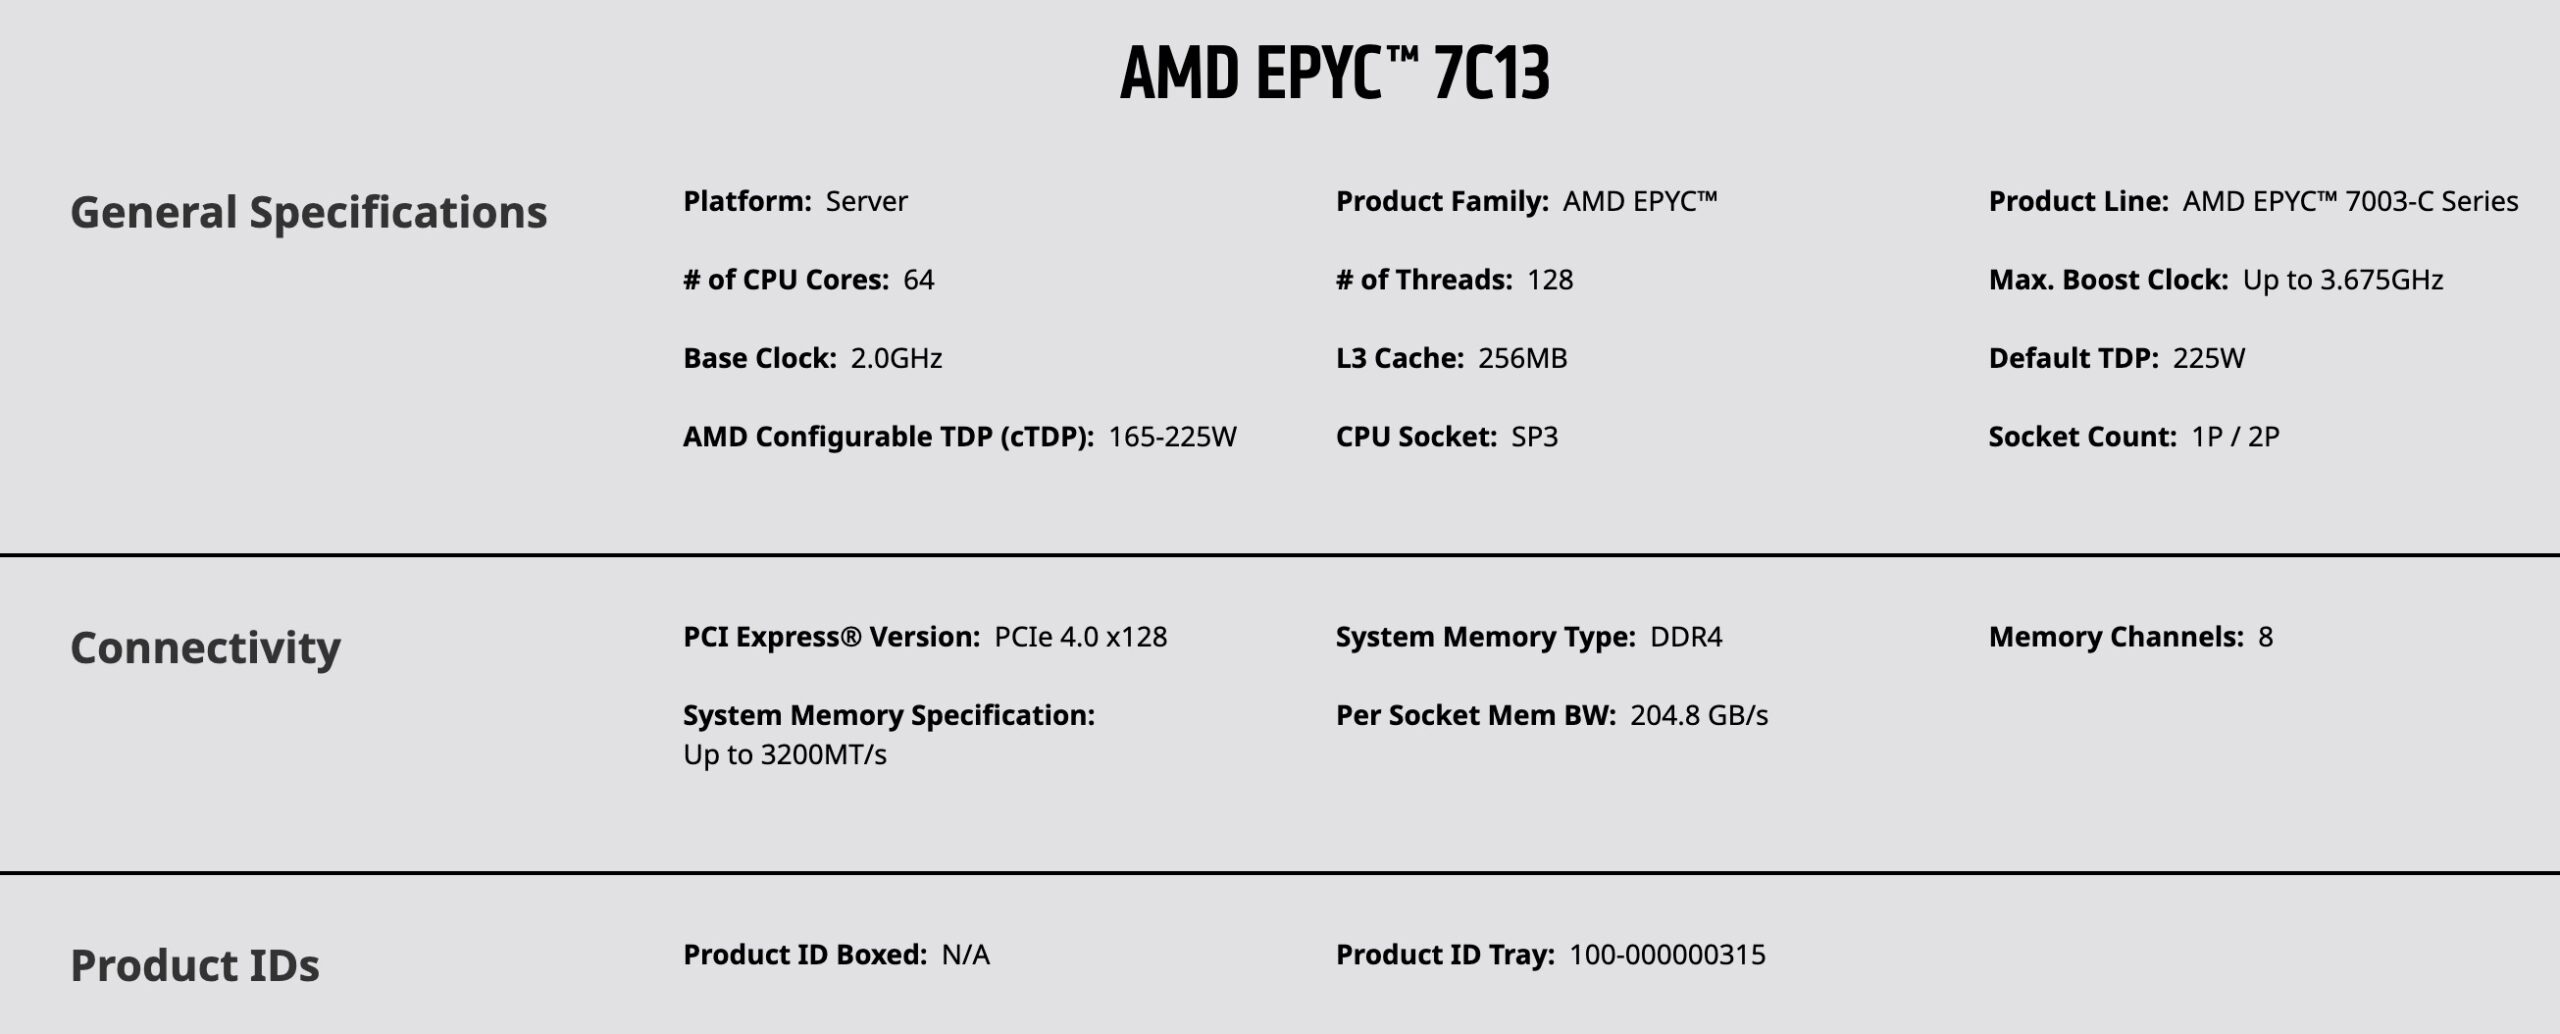
. [6 a; D" g" M6 E2 b0 [2 n第二:CPU和主板。CPU我选AMD Zen3架构( Zen3是DDR4的最后一代)的服务器芯片EPYC 7C13, 64 core 128 threads, 市场价仅$700+。它与正式发布的7713结构一致,频率略低,有人怀疑类似于Intel的 ES(工程样品)。主板支持Milan的SP3主板即可。唯一要注意的是内存插槽数,根据DDR4单条内存的容量大小,要能够插出512GB来。/ X3 I+ x. t) S) P7 Y5 \

; G& Y8 i) ]4 _5 k9 b  F# W9 z$ u4 e1 @. o9 Q! f' X' u
第三:显卡。双3090或者单4090。4090不好买,用两块3090大致能抵上一块4090。
+ K1 f* x2 c8 W3 e6 f+ S0 z) q4 U0 E& d2 K( B6 I/ Z
第四:硬盘。这个要求真不高,如果机器仅仅是为了跑DeepSeek,一个4 TB
0 p1 q% A0 l# L6 o(或者两个2 TB)的nvme就够用了。(想当初我在爱坛上发记录推荐固态盘时,一块4TB的才$150)$ u' [1 N/ J1 p" t+ I' d/ U) X( Y

( x5 W; ?. _$ R1 v2 b其它:说3点。1)普通PC机箱。2)散热避免使用服务器的暴力风扇( PC机箱也缺乏服务器的风道结构)。如果散热量大,考虑用水冷。3)如果单台大功率电源太贵,可以用两台小的给主板和显卡分别供电。如此需要双电源同步启动板或者同步线,但那东西淘宝上也就人民币10块钱。
$ K7 ]9 P  \/ g4 Q" q  G* n0 N! f1 s: r: ~" ]4 J8 I: B; D+ _& m) J9 j9 ]) C
最后汇总一下。数字为能够淘到的大致美元价,可以接受二手货,+、-表示向上下浮动不超过15%7 u/ r: R% O9 q/ B
+ G2 c# m+ b2 w- t9 A
RAM 512GB DDR4       1000+
" a! f$ y- R; r( J9 t2 b) zCPU 7C13或相当           700+/ T/ T! e! I, K/ B5 k
主板(单路即可)         500
9 n8 g7 {% O2 X6 C+ `, S6 m3 P5 F4 K显卡 3090                  1000- ×2: ]8 H) V$ e2 N( {3 ?7 y. s
固态硬盘                     200+
% x2 ^) q  ~  G' l2 Y2 C其它 机箱、电源、散热器等
2 u# A) \+ }' ?7 f# D$ d. k( L7 d
% E. v% q$ {' J4 H, f, O7 K; Y# ?. |
作者: 大黑蚊子    时间: 2025-2-20 16:27
本帖最后由 大黑蚊子 于 2025-2-20 21:55 编辑 8 i! K! j/ B% O  ?  P2 T' N5 Z
# ]$ z4 A8 s* r+ ^9 M- |1 W
说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径了" j* V* O& U' g. t% y# `
在硬件选型上面我倒是有点儿不同意见,鉴于章明星他们在0.3版里使用amx指令集加速,那么支持amx的Intel至强可扩展CPU应该是要好于AMD的EYPC的,具体来说现在Intel最新款是6代至强,退而求其次选择四代或者五代至强应该也满足要求。章明星团队他们的硬件好像也是双路Xeon 6430& u8 {) ]( r5 q5 j
但是这个成本可能要比你说的EPYC要高不少,但总的来说应该还在可承受的范围之内: c, f. G' r0 t+ g& e0 U$ G1 m
显卡的双路配置好像不是特别必须的,主要是4bit量化版需要14g显存,所以如果有一块3090先用着应该问题也不会太大,实在不行多买一块也可以1 I' d  k6 ?3 f7 m1 n) w

5 \, ]4 L. H/ r" h周末去华强北转转去,看看二手服务器有啥准系统能够直接上手的
作者: 马鹿    时间: 2025-2-20 21:42
我看到了国内AI的商机。。。 攒小配置的AI模型!
作者: 马鹿    时间: 2025-2-20 21:43
关于方案, 我直接问过deepseek。。。
作者: 马鹿    时间: 2025-2-20 21:45
大黑蚊子 发表于 2025-2-20 03:27# k  C: V9 X  A8 L: W
说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径 ...

# ~( m! Z: C7 E- U0 X0 g真心羡慕国内了。。。我90年代自己攒过打游戏的计算机。。。
作者: testjhy    时间: 2025-2-20 22:50
马鹿 发表于 2025-2-20 21:457 Y. {$ D* C" H+ O
真心羡慕国内了。。。我90年代自己攒过打游戏的计算机。。。
' Q6 P0 Q% e9 f
社长,美国不是与国内PC价格差不多吗?也仿照沉宝蚊行攒一台呗,
作者: 马鹿    时间: 2025-2-20 23:19
testjhy 发表于 2025-2-20 09:50
% `" V# Q: Y  [1 E; @社长,美国不是与国内PC价格差不多吗?也仿照沉宝蚊行攒一台呗,
4 D( p! R2 Z6 q  U  X7 @: `( S
攒了以后干啥呢?
作者: testjhy    时间: 2025-2-20 23:32
本帖最后由 testjhy 于 2025-2-20 23:41 编辑 ) E% f. |0 @! ^0 R0 [4 Z- U
7 Y* z7 G+ w" F- b8 t5 r" E

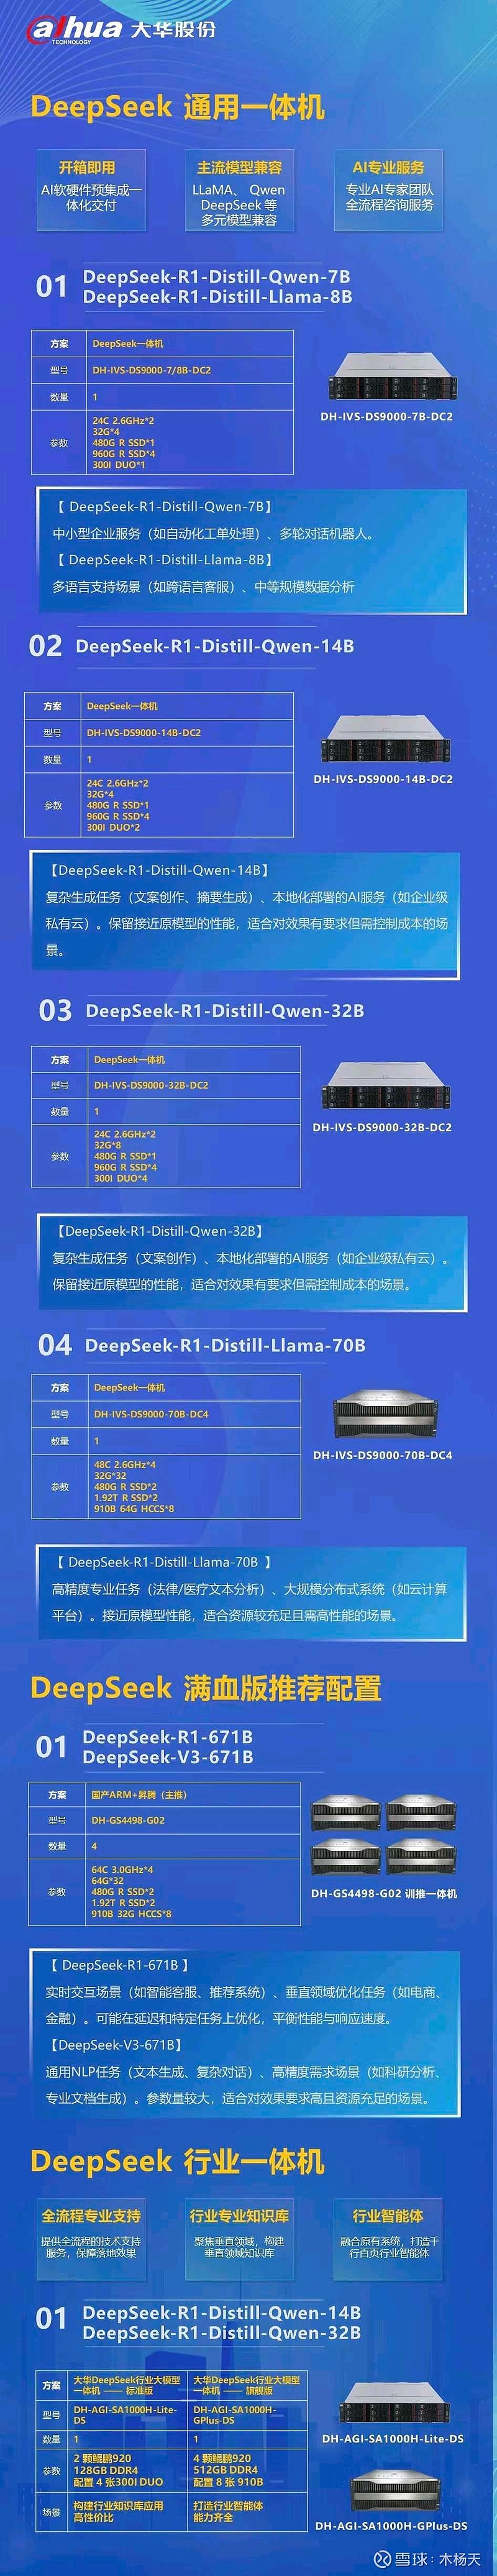
  N3 F9 P  T6 H& T1 Z% c9 O这是大华股份根据国产芯片的一体机,估计是华为提供的方案供各家贴牌
作者: 大黑蚊子    时间: 2025-2-20 23:38
testjhy 发表于 2025-2-20 23:32+ K1 I) d0 I3 ?3 T9 Q  S( A
这是大华股份根据国产芯片的一体机,
( r& J" v7 U2 T$ }$ z: v; E6 U! M
大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型
# k" U3 w' M% A我在自家电脑上搞了一个7B的模型试了下,真的是不太行; }1 @5 z4 N8 ~% ~7 P! ?: `
我估计32B和70B也都不太行& ~6 S/ [9 P/ c% _$ k
这个帖子里讨论的应该是直接上手671B的满血量化版,1.58或者4bit版本,这个据多个信源反馈效果挺好的6 |, h/ y, o' v# @) ~
4 i$ J9 X  {7 O  r$ N7 E' {  T! y
) M0 `. d! B' Z$ F% G; f5 ~
不过这个单子我倒是可以拿着去嘲笑下大华的朋友“你们钻钱眼里了?搞这个文字游戏骗钱”
作者: testjhy    时间: 2025-2-20 23:42
马鹿 发表于 2025-2-20 23:19
4 r0 x" v/ O5 `" r1 n攒了以后干啥呢?
# ^# O# W( i# v% p- e2 }2 O
想干啥就干啥,吃喝玩乐,
作者: testjhy    时间: 2025-2-20 23:45
大黑蚊子 发表于 2025-2-20 23:38- f, e6 i- f( L4 [
大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型
+ f3 r4 t3 f7 o( F  j$ q我在自家电脑上搞了一个7B的模型试了下, ...

1 \$ ?8 A( U1 e9 c找了一个非剪裁图,看了一个新闻,华为提供方案,有60多家企业响应,大华可能是比较快的,找不到价格,
作者: 大黑蚊子    时间: 2025-2-20 23:53
testjhy 发表于 2025-2-20 23:45
* V7 Z, n) w# V  V& ?- w* w4 a9 p找了一个非剪裁图,看了一个新闻,华为提供方案,有60多家企业响应,大华可能是比较快的,找不到价格,{: ...
( u0 v% C9 {1 J. [9 s! U$ O
我要是鼓捣这玩意儿,肯定是找二手硬件啥的,全新设备的价格那还是相当辣手的  m. h& b& R8 }  m" ^
打听了一下Intel的至强4代CPU,现在全球缺货,嘿嘿& t  p9 }1 o* P7 h1 \0 I
去华强北看看有没有QS版本,可能一块就要6000人民币至少
作者: 马鹿    时间: 2025-2-20 23:53
大黑蚊子 发表于 2025-2-20 10:38
/ P4 D' G4 O! r" V大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型$ R; \# x& K( U8 ]
我在自家电脑上搞了一个7B的模型试了下, ...
% b) Q# Q3 m1 g6 p% d$ v. r
好奇你攒个模型做啥?
作者: 大黑蚊子    时间: 2025-2-21 00:03
马鹿 发表于 2025-2-20 23:535 |& C. M: O" K9 l
好奇你攒个模型做啥?

" t- |' ^8 Q1 d" p6 g, A' t- B3 N, U% ~" J0 Z
玩啊,好奇啊,这很可能是通向新世界的大门
  ^: r+ s: k# l# r9 T有这个条件的话,干嘛不玩?
9 L( v, @4 K' s$ T$ p" E( F& t% K
现在大部分人还在懵逼状态中,只是知道个大模型的东西,具体怎么搭,个人知识库怎么建,私有服务怎么处理...好玩的需求多着呢
# O4 Z. L+ H6 N8 f7 w5 d0 }3 V& ^* R+ f4 e$ U" v# x
DeepSeek的出现,极大降低了大模型训练和部署的总体成本0 P" Q) t5 A+ J- Z
KTransformer架构的出现,打响了极大降低大模型部署和私有知识库服务的硬件成本的第一枪6 C8 a& d4 b, G
2 h; z! y: U: J) ^
这种能够降低90%成本的新技术出现,大概率后面会蕴藏着10亿级别的新的相关应用和服务空间* z9 n  s, N% T8 C# J: @" q% s- U. t
玩的过程中也可以吸收很多其他的知识,认识其他稀奇古怪的人,包赚的啊
作者: 沉宝    时间: 2025-2-21 00:16
大黑蚊子 发表于 2025-2-20 16:278 k5 j0 y+ |. ?0 \
说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径 ...
0 n# w* |( r6 J; o
这取决于对问题的理解和取舍。首先在大模型计算中,GPU的能力远远强于CPU,即使那个CPU有amx指令加速。所以在预算有限的前提下,应该尽量省下钱来加强GPU。当然如果实测一块3090够用了,那更好。
- q( ^3 ?9 k1 R5 {7 N/ B- K6 k( Q" @; V* N- G% M  _
对比EPYC与Xeon 6530方案。Xeon 6530 2023年底发布,还比较新,主板加CPU的折扣有限。而EPYC Milan则要旧得多,有大批从数据中心退下来的二手货可选。即便有amx加成,但架不住7713的核多,单挑的话还是应该7713赢。而双路7713的话只不过比我的原方案多一颗U的钱,其它几乎不用改。个人认为CPU的第一位作用是保障参数全部装载在内存,计算加速还在其次。章明星团队的努力是充分挖掘手头现有硬件的全部潜力,amx加速是新版才加上去的,可见并非重中之重。
作者: pcb    时间: 2025-2-21 01:42
大黑蚊子 发表于 2025-2-20 23:53
+ p; ^# v; |! ~5 S我要是鼓捣这玩意儿,肯定是找二手硬件啥的,全新设备的价格那还是相当辣手的% R2 q7 S% f6 D) z
打听了一下Intel的至强4代C ...

: R8 U' c. U0 \% U/ M"至强" 是 Xeon?
作者: 马鹿    时间: 2025-2-21 02:29
大黑蚊子 发表于 2025-2-20 11:03. |; u+ f! e" Y2 U  e
玩啊,好奇啊,这很可能是通向新世界的大门
0 z0 i6 V6 R- B3 }; _- n有这个条件的话,干嘛不玩?

# m$ i! L4 r" Q% s# q: O握手, 我也是,就是好奇。 也同样认为这是通向新时代的大门。
作者: xut6688    时间: 2025-2-21 05:30
在本地部署满血版的DeepSeek R1, 性价比太低了,还不如用各个云厂商的API。 自己学习,玩一玩用云API就好。至于本地部署的蒸馏R1,我试过各个版本包括70B的,效果都不好,和原版差太远。我自己玩着用本地部署的模型做了一个RAG应用,最后发现蒸馏R1还不如原版的QWen2.5 32B。
作者: 大黑蚊子    时间: 2025-2-21 09:06
xut6688 发表于 2025-2-21 05:30( M6 N" H3 [/ g1 F
在本地部署满血版的DeepSeek R1, 性价比太低了,还不如用各个云厂商的API。 自己学习,玩一玩用云API就好。 ...

8 M# t: w/ ]# ?; O1 _% l所以为啥盯着671B的版本呢,就是这个原因,其他版本的性价比其实都不好。3 ~% @, D5 m3 N! s
3 c* y5 B* d$ J
目前有海量的本地部署满血版DeepSeek的需求,因为太多的数据受商业或者法规的限制不能上网,这个部署的整体过程是有很大市场需求的。' f8 P+ Y) b  ?0 Y* O3 P$ M$ ]
+ o' V+ D6 [" e7 r* x3 E
DS和KT的诞生,不是拉低了对算力的需求,而是通过降低成本做大了整体算力需求。
; W- R8 B; N7 Q
, m- ~4 H* d) W9 t4 G) ?( X而且部署过程中的调优和配参,踩过的坑,以及反复琢磨和资料学习的成果都是自己的。+ \# I9 ~* M+ N" u) z

* ?! h5 c8 k9 r% Q5 ^& M再说了,都是二手硬件,搭完之后上闲鱼卖掉,亏不了多少钱
作者: 大黑蚊子    时间: 2025-2-21 14:10
沉宝 发表于 2025-2-21 00:16
. c3 ?7 O# c1 y- F9 ?- a$ ^这取决于对问题的理解和取舍。首先在大模型计算中,GPU的能力远远强于CPU,即使那个CPU有amx指令加速。所 ...

/ ^# z! w. c; G( b5 t我建议你再看一下KTransformers的相关资料
6 L, P6 d3 z$ y6 m& h) v4 Q2 P8 n这个玩意儿的本质是在低并发(甚至是单并发)的情况下,高度依赖CPU/DRAM带宽,从而降低GPU需求的降本做法。3 ~) e) ]! u5 {- i7 S
DDR5换DDR4的话,带宽砍半,对应token的数量就要起码减半
' D. p0 Q1 K" q! }6 jCPU的带宽再砍半的话,又要丢失速度
  |/ m  j0 x6 }5 F0 f3 ^如果CPU/DRAM带宽不够的话,甚至3090可能都喂不满,无限下降螺旋在降低成本的同时会极大影响使用效果
. C" Y* I, X- G$ S- @( I# a3 }对于咱们来说,跑起来不是胜利,能够最低限度可用才是核心需求所在啊
8 |, E+ k; p; o0 }: W  X+ ]我觉得起码要搞个输出4-6token/s才行吧
% M  w3 K1 g! P0 t( L4 t按你这个方案我估计可能1-2token都悬
作者: 沉宝    时间: 2025-2-22 00:10
大黑蚊子 发表于 2025-2-21 14:10: U! }4 J: v* C" K
我建议你再看一下KTransformers的相关资料3 X$ e9 R1 d' d) }
这个玩意儿的本质是在低并发(甚至是单并发)的情况下,高度依 ...

! s3 o4 `" l3 t  o4 Q欢迎讨论。
# X( [5 L$ w& I+ p6 u
5 |8 C3 z' a4 w# N* ?首先,个人以为KTransformers的最核心最精华的是抓住了DeepSeek模型参数的稀疏性。DeepSeek是基于MoE的,回答某一个具体问题时只有部分参数高度活跃。KTransformers可以动态调度,把这部分高强度计算交给GPU(好钢用在刀刃上),剩下的则由CPU完成。所以CPU部分对系统整体性能的影响不如GPU大。作为佐证,上一帖我提到了章明星团队在几次版本迭代更新之后才把amx加速添加上去。  L  ?  ~" D- ?; i

+ n1 S7 W# ?2 ?6 k& N/ }& [CPU/DRAM带宽对系统性能的影响不是简单线性的。老实说,我没有咱们现在讨论的这样大的系统的实际经验。我只能根据在台式机上看到的现象做一些外推。Intel的12代和13代同时支持DDR4和DDR5,DDR5内存下整体成绩要比DDR4好一些,不过差距并不大。至于到显卡的带宽,我也可以说一点。我们知道目前大部分显卡的插座都是PCIe×16。外置显卡时,因为各种原因往往不做16路通道,比方说仅仅实现了8位通道。那么这个PCIe×8的显卡游戏性能下降多少呢?绝对在30%以内,常常也就10-20%。
* P* o2 M1 T* k; t3 K& N* e
8 `1 z6 T' F' v1 B以上这些是我没有简单照搬章明星团队的配置,而为省钱做了一些变更的原因。
作者: 大黑蚊子    时间: 2025-3-10 22:25
沉宝 发表于 2025-2-22 00:10
' S. u; y9 N: B! n3 F/ y. r( w欢迎讨论。8 o3 n/ K% B- U* o. u, `6 c
$ c( Q4 e  ]4 [/ s1 S! I# j2 a9 D) ?
首先,个人以为KTransformers的最核心最精华的是抓住了DeepSeek模型参数的稀疏性。DeepSeek ...

3 M  k+ D- x; d刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本) S& ?6 \- Q& ?, Z' i- d4 a7 \
显卡用的是3070M 16G,环境是Ubuntu 24.04.2  _9 A/ V+ Q, [* W$ m+ }
输入大概是10不到一点,输出大概是5,勉强可用
" m" ~. g8 \  H/ M3 ]6 H' w+ I因为都是整的垃圾配件,总体的成本大概不到4000人民币( ^! _# c$ A+ s+ z$ g) t

9 R: R! N! G% b+ u$ K( H0 A我估计如果他能够用DDR4+至强的话,应该可以到7-8的输出
- U4 a( c- H# I. j4 ^, u如果是这个速度的话,个人轻量使用已经没有特别大的问题了
作者: 数值分析    时间: 2025-3-10 23:42
这里有篇文章是谈万元以下服务器部署DeepSeek-R1 671B + KTransforme的% ~( [+ t, M' ?/ T6 D
https://www.pmtemple.com/academy/17340/
( a3 x  \& L! b1 k+ Z  R6 [; d
作者: 孟词宗    时间: 2025-3-11 01:50
大黑蚊子 发表于 2025-3-10 22:25: X8 w3 Y1 m1 l* Z9 `8 T: @$ H- N
刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本
- L! L8 u+ \: S$ d3 D- g显卡用的是3070M 16G,环境是U ...

6 L7 @& I# T, D( ^6 c0 v
* A+ C' i  g/ G8 Z: l- [我觉得别对Q5以下的版本抱太大希望。Q5 以下只能说是能跑,但效果实在不敢恭维,很多情况下出来的回答都不是 AI 幻觉,而是文不对题。在决定投钱搞硬件前,还是建议先化小钱租个服务器,下载不同的压缩版看看效果再确定要用哪一版,用什么本地硬件。
作者: 沉宝    时间: 2025-3-11 02:12
大黑蚊子 发表于 2025-3-10 22:25, z; @3 p1 E5 _6 u
刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本( V- ^. i) S1 O! |$ c$ X: n* S. H
显卡用的是3070M 16G,环境是U ...

: Y% U9 E/ Z2 w8 a+ _# ~3 W/ l3 k# y这做得很厉害了。点赞!
作者: 沉宝    时间: 2025-3-11 02:14
数值分析 发表于 2025-3-10 23:42
. a* i. D5 _. m' R6 a  o这里有篇文章是谈万元以下服务器部署DeepSeek-R1 671B + KTransforme的- P- `6 t. I6 |* e3 {
https://www.pmtemple.com/academy/ ...
" p( L5 Y2 j4 x% `' f
这么多案例,很有参考价值。
作者: 孟词宗    时间: 2025-3-12 01:39
有 512 GB RAM 的话,基本 Q3 以下都可以跑。Huggingface 上量化版不少。例如这个:https://huggingface.co/unsloth/DeepSeek-R1-GGUF 从 Q1 到 fp16 都齐全了。Q1 的几个版本甚至只要 256 GB 就可以跑了。  c) d' ~# S! G% g0 f! p+ \0 r
4 k+ f. e" r+ s4 G% V1 f. I
但是,量化版压缩了尺寸,同时也压缩了功能。个人感觉 Q5 以下基本都是渣渣,回答大多逻辑不通。
作者: 孟词宗    时间: 2025-4-15 10:41
大黑蚊子 发表于 2025-3-10 22:25
, t- N) A' s7 ~刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本
  B  {+ Q3 R5 M$ r' i) Q显卡用的是3070M 16G,环境是U ...
4 M6 _1 |* i) [. M
性价比更好的是 HP Z840。这玩意儿有2X Intel Xeon E5-2678 v3 up to 3.1GHz (24 Cores Total),最好的是有16条内存槽,按 Intel 的说法,每个 CPU 可以到 768 GB DDR4。两个就是 1.5TB (实际 HP Z840 号称能到 2TB),正好可以跑 DS-R1 671b 完整版了。
作者: 雷声    时间: 2025-4-15 11:18
孟词宗 发表于 2025-4-15 10:410 G% T8 k! `0 @% O; E
性价比更好的是 HP Z840。这玩意儿有2X Intel Xeon E5-2678 v3 up to 3.1GHz (24 Cores Total),最好的是 ...
( e! J( w1 _3 y* e& n
https://cloudninjas.com/collecti ... 40%20will%20support,Reduced%20server%20(LRDIMM)%20memory.
" I  U( O$ a  g3 D  Y3 \, O; ]5 ]" X! B; P# f% }: \
The HPE Z840 will support 4GB, 8GB, 16GB or 32GB DDR4 Registered.
3 G. j  l% H  m) yThis server will also support 32GB, 64GB or 128GB Load Reduced Modules (LRDIMM).
& B3 q* j) l6 z' vThe Maximum amount of RAM the HPE Z840 server can hold is 2TB (16 x 128GB) of Load Reduced server (LRDIMM) memory
: s5 i. K" g, t% _4 d- c5 L: H
( }! g) A9 ]1 Q' P7 {3 ^( _3 [LRDIMM 128GB的话一条要1400~2000刀,16根的话。。。。 好像也不便宜了。
* B! q, r4 g" F% mZ840倒是不值几个钱。
作者: 孟词宗    时间: 2025-4-15 11:58
本帖最后由 孟词宗 于 2025-4-15 12:01 编辑
8 T4 b5 y6 [% P
雷声 发表于 2025-4-15 11:18( z5 \* [9 I( I) u" M& X7 _) O
https://cloudninjas.com/collecti ... E%20Z840%20will%20s ...

3 A* y2 |+ i9 }% V- k' T! w% N
* q* w" j) w* K) j4 o! g没那么贵,Amazon 上一条才 $239。16条也就$3,824。
" H  I  Y  r( k* _' p4 N1 G; j, F$ ~& n: w* B
https://www.amazon.com/Tech-2666 ... cp-nq_eMQV&th=1
: S/ d( A! k/ N" M6 s# R) G1 n, b9 H  S. f
1TB 的kit 稍微便宜一点, $1,908, x2 就是 $3,816: https://www.amazon.com/Tech-8x12 ... amp;sr=1-1&th=1$ F9 {) ], l9 O, \% O! ?

. c+ Y, P/ b! [& H. A但如果上 2TB 的kit 反而要 $4,319 : https://www.amazon.com/Tech-16x1 ... ctronics&sr=1-6  ^5 T: _0 v% i+ f; q: q
. h" I! X' P( `& K
& I5 {2 ?' x+ S+ W. m7 J1 [# ^
当然,真要上这个,最好买以前和卖家咨询一下,这些 RAM 是否可以装 Z840。我估计 Z840 出来这么多年,大概最多也就有人装到 128 GB,毕竟这不是 server 而是个工作站而已。
作者: 孟词宗    时间: 2025-4-15 12:14
雷声 发表于 2025-4-15 11:18
& X  y0 c/ o6 y8 `7 Ghttps://cloudninjas.com/collecti ... E%20Z840%20will%20s ...
5 ], V5 F, Y2 f0 v; @$ G
. s# s* k+ u+ t* \. f6 O; M2 B
顺便说一句,如果只是要跑压缩版的话,我在另一个帖子(http://www.aswetalk.net/bbs/foru ... read&tid=161700)里已经说过,如果有192GB的 RAM 就可以跑 IQ1_S(131 GB), IQ1_M (158GB)(假设没有显卡加成)。
: ~# \' b) R4 r: V2 \8 Q* m- L) R& E* c( C" J3 Y/ ?
不要显卡的话,搞个Intel core ultra 9 285k 或者 AMD Ryzen 9 9900x3d 加上 192GB DDR5 和 4TB 的 SSD,一般也就 $1,500 左右就搞定了。
作者: nanimarcus    时间: 2025-4-15 12:58
散热的问题,你把机箱敞开,左右两片直接给拆了,开个小风扇对着吹就是了,斜着吹,从前往后,CPU显卡电源一起吹,别去搞太复杂的冷却方案,水冷复杂且容易坏。: ?8 U9 y, P6 H- `% v$ e; N' ~: e
当然,有点吵,放在别的房间,用网络连接好了,命令行,远程桌面都可以。
* d/ V% H; A$ s: H服务器那种结构就是隐含你用那种暴力风扇,对散热并不友好。
* F9 ~# F$ [) k/ g6 n4 i) b$ P: d我的GPU上的CUDA跑满都可以控制在80度以下。
3 p4 W+ z. g$ ^( |当然奢侈一点,放在空调房,调节一下空调出口,把机箱放在桌子上,对着机箱吹能降下很多,这才是真正的水冷加风冷。
作者: 孟词宗    时间: 2025-4-15 13:48
如果是为了跑本地大模型,显卡没有必要搞顶级的家用卡。相比速度,更重要的是显卡的显存有多少。8 x: o7 |. C. o0 @7 W

4 G3 G! L5 L. m从性价比来说,两块3090比一块4090要好,这是因为3090仍然支持 NVLink。连接后显存会显示为 48 GB。这就可以容纳很多模型了。9 s1 ~* n. {2 y6 d+ P; G0 R% P

: Q9 X, |; c+ _1 m但3090的问题是功耗, 350W 起步,两个就是700W,对电源要求高了。而且还得找有足够空间的主板和机箱。而且价格也不便宜。4090 现在给炒到 3650 美刀左右,3090 则是 2000 美刀。加起来就不是小数字了。# u6 r# F7 L3 y2 D1 c1 Q
/ y' {" D) z( ?  E( G. z4 @
对于显卡,我倒是推荐这个:PNY RTX 4000 Ada VCNRTX4000ADA-PB 20GB, 市价1500 美刀左右,有20GB。虽然不能串联,但这是个 Single Slot card。一般好的主板能塞三四个。功耗单卡才130瓦,三个加起来也就才相当于一个3090。而三个卡加起来 60 GB,Ollama 可以跑很多 LLM 了。
% L, ]2 W& d2 r0 q1 F6 |( {8 K- e3 G: q% f7 g
否则也可以弄个 PNY NVIDIA RTX 4500 Ada Generation 24GB GDDR6,这也就2300美刀左右,但显存和4090 一样。两个加起来相当于一个 4090 但显存要多一倍。
. l% x, F3 w% M" C' ]" H! d- S; a; ]/ l+ d
当然,俺的理想卡是公布但还没有正式开售的 RTX PRO 6000 Max-Q https://www.pny.com/nvidia-rtx-pro-6000-blackwell-max-q。这玩意儿有 96GB 显存,还可以用 NVLink 串联。最大可到四张卡384GB,而单卡功耗不过 300W。
; v% F" ~  _' r/ p! o1 Z6 N% |4 {* V0 g8 p# f3 W& Y
当然价格据说也挺感人,要 $8,565 单张。
作者: 孟词宗    时间: 2025-4-15 14:12
nanimarcus 发表于 2025-4-15 12:58
* t: ]3 G2 d+ t1 Z0 M- B' _4 G: ?$ S7 S散热的问题,你把机箱敞开,左右两片直接给拆了,开个小风扇对着吹就是了,斜着吹,从前往后,CPU显卡电源 ...

. r3 i% J/ T* W. B同意风冷,但用不着这样 DIY。可以用 联力 LANCOOL 215 https://lian-li.com/product/lancool-215/。这机箱正面两个200毫米的风扇吹气,后面一个140毫米的抽气,足够用了。用风扇的时候,机箱应当关上,这样风速比敞开的更快。
( \# Y. K' c, }) b0 j
' y' _) p+ F2 @- s* O/ D+ O+ _CPU 和 显卡的冷却还是不能省的。倒不是风扇,而是它们的散热片不能省。有了散热片才能有效散热。风扇本身是不是装在CPU和显卡的散热装置上不重要。
作者: nanimarcus    时间: 2025-4-15 17:35
孟词宗 发表于 2025-4-15 14:12  F2 l& z: I" {$ O+ a8 u- T# z/ X/ H
同意风冷,但用不着这样 DIY。可以用 联力 LANCOOL 215 https://lian-li.com/product/lancool-215/。这机 ...
5 A* W8 B0 L' N3 V
我有点成见,总认为机箱上的风扇不够有力,呵呵。. _$ Y, L: b7 D6 i7 n

% y3 T8 Z+ Z6 m; N5 Y所以总认为机箱敞开了另外架个风扇吹特别有力,至少视觉上如此。
  Z5 m0 s1 J" _
4 K2 q  g1 n& V: t3 s1 u# p% t所以我的理想型机箱就是一个框架,其他统统敞开了,吹!
% {1 j( \1 t& ~
, A: Z8 W7 l) W1 j0 g3 `3 K另外,CPU上带的散热片过于庞大,多少会造成主板变形,所以我的机箱是平放的,如此一来显卡是竖起来的,这样两个最重的部分不会造成形变。
作者: 孟词宗    时间: 2025-4-15 21:45
nanimarcus 发表于 2025-4-15 17:35
0 d0 F/ q: C0 [" M我有点成见,总认为机箱上的风扇不够有力,呵呵。9 h8 x- J, y! y5 u* S1 S
; A& W' w5 N% ^) j; u
所以总认为机箱敞开了另外架个风扇吹特别有力,至少视 ...
7 O- f5 U( B9 t% n
Caseless 的 DIY 电脑现在也挺多的。散热和灰尘啥的不是问题。
6 c4 j; O4 \# |
9 @9 c4 D* V. B) [& `0 E2 G7 `/ F. B: I- J9 g7 @  x0 E  h1 {. ~9 ~/ d
主要问题是像下面这个放桌上的,如果一不小心撒点饮料上去就容易把电脑废了。
3 G8 }. Q/ o# i/ X# e. l
3 O, q: @- z5 W0 R- B3 c# ]; j2 M$ P% S9 B) ]7 `3 k
所以一般都是挂墙上的。造的好点的话还是挺科幻感的。
. V, Z7 }% t+ W5 F1 v! E+ B
作者: nanimarcus    时间: 2025-4-15 23:26
本帖最后由 nanimarcus 于 2025-4-15 23:27 编辑
' z6 G3 F# ?, W( Y+ q6 K
孟词宗 发表于 2025-4-15 21:45& d5 [  A( b/ O! W
Caseless 的 DIY 电脑现在也挺多的。散热和灰尘啥的不是问题。

- x, _3 X& r7 }8 D
! @5 z% v/ n" j4 q/ `这个确实很赞。5 m! B2 g4 M# h8 a" K9 l

6 h" o$ O! g7 A/ o; m' J第一三张好像放不了全尺寸显卡。1 w; A2 I/ a! i  ]
第二张全尺寸显卡的散热好像不太好。
作者: 孟词宗    时间: 2025-4-16 00:07
nanimarcus 发表于 2025-4-15 23:26. \+ W( t- b0 ~( r/ \
这个确实很赞。
* Z! h) Q, _8 o8 x. P8 O5 q) {7 t: N
第一三张好像放不了全尺寸显卡。
6 I% D$ ^; E; I8 L
都是全尺寸显卡。第一、三两张中的显卡散热被魔改成水冷了。所以看不到明显的显卡。实际上两个机器应该都是双显卡。第二张的显卡问题不大。很明显不是80或90级别的。根据电源才600W来看,应当是3060或4060级别的。这个显卡的原装风扇还在,制冷应当还行。
作者: 雷声    时间: 2025-4-16 07:27
孟词宗 发表于 2025-4-15 11:58
4 z7 g4 o* W' }1 n, X& @没那么贵,Amazon 上一条才 $239。16条也就$3,824。) f3 J: J% G$ A5 u' ~5 g
0 j5 }$ @/ F! p  G3 M8 I2 j" Q8 I
https://www.amazon.com/Tech-2666MHz-PC4-21300-Wo ...
5 I* Q$ z0 l+ Z# r
HP Z系列G4以后支持Intel® Optane™ Persistent Memory,买二手的话更便宜。不过表现怎么样就不好说了。
* p6 Y' Y8 Z5 K# ~! T# H# dZ6/Z8 G4也可以上到2TB,加上PMM的话更多,价格比Z840也贵不了多少。) v8 b# L# @+ `8 j
话说Z系列是真不错,我09年买的一台Z8现在用的好好的,而且比公司配的新Alien还快。
作者: 孟词宗    时间: 2025-4-16 09:55
本帖最后由 孟词宗 于 2025-4-16 10:03 编辑
- D& k' w% k( z
雷声 发表于 2025-4-16 07:27
$ A# r$ e/ B/ c: v5 j6 V7 NHP Z系列G4以后支持Intel® Optane™ Persistent Memory,买二手的话更便宜。不过表现怎么样就不好说了。 ...

+ e- c$ u/ I' F/ B+ K# e  ^; p* K8 t, x; W% u& l# y
HP Z8 G4 号称可以最高支持 3TB 不过这得看 CPU。如果单个 CPU 只支持 768 GB的话,那两个 CPU 最多也就 1.5 TB。大多数旧的 HP Z8 G4 都最多 1.5 TB。
8 S( u: V9 S  p% D" a+ a* b3 }8 Z: W9 @+ ~$ f* j9 t
性价比来说你说的很对,Z8 G4 的确更合算一些。尤其是不少旧机器本身就带了 1.5 TB。这比自己买要合算多了,也省事多了。  \; h1 G! j" M# ~, ~8 S

) I8 C0 k5 F( t' t0 M2 A: q5 o从跑 LLM 的角度讲,应当是可以跑,速度勉强可以接受的程度。俺那个三年旧的机器,如果不用显卡,跑 DS-R1 的 70B 蒸馏版最快也就两三个token每秒。Z8 G4 跑DS-R1 的671B版本应当只会更差。毕竟内存更慢,模型更大,CPU更老。
作者: leekai    时间: 2026-4-18 21:09
我去年春节也攒了台x99 双路e5v4+256+2080魔改22g*2,硬盘因为以前装nas不用买,后来淘了Dell730 HP z440,用下来感觉单路CPU更合适。期间装了N多大模型,现在只剩ragflow+qwen 3.5 ,35b做map,27b做reduce,都刚好可以单卡运行。前两天刚跟风试了turboquant,效果挺好。今天发现qwen 3.6发布,并且有UD IQ4量化,正在下载准备试试。* l6 n  o6 G! f3 [$ z) ]6 Z
现在有更好的选择,IBM AC922,六块v100 16g准系统闲鱼上报5800元。
作者: 沉宝    时间: 2026-4-19 11:10
leekai 发表于 2026-4-18 21:09, L3 G% i$ F- N" R
我去年春节也攒了台x99 双路e5v4+256+2080魔改22g*2,硬盘因为以前装nas不用买,后来淘了Dell730 HP z440, ...
" _4 T" a9 h% G$ I
2080和v100的优点是可以通过NVLink 获得很大的显存。缺点是缺乏 fp8 等先进架构的支持。不过看在那价格上,还能说什么呢?!
( e! Z$ U, w% W* v6 D; C! L* `! u' m
今年较之去年,最大的一个变化是像小龙虾之类的智能体流行起来了。通过不断的自我进化,智能体在很多方面可以达到和超过简单使用混合专家模型(MoE)。而智能体的后台模型,如果想跑在自己的机器上,小一些的稠密模型其效果往往好于MoE。与人相比,智能体的AI对话中提示词的长度平均增长了许多倍,从而也就要求更强的KV缓存。如此turboquant正逢其时。2 T+ U- c* R( N! x# x7 K9 W

& H3 @& N* @( V8 `* n' A比TurboQuant更强的还有RotorQuant。感兴趣的话可以关注一下它在你使用的模型上落地的进展。
作者: 大黑蚊子    时间: 2026-4-20 13:43
回首这个帖子
/ Z  O: U7 S. [! C* i7 A  e% d如果去年就下手干他1个T的ECC DDR5内存的话...
, O5 _% U# {8 G4 I/ Q- f  P
5 ~5 _* d# }: y3 Y- Y* G0 Y0 |  y! e俺就不用今年年初买个128G内存条那么心痛了
作者: leekai    时间: 2026-4-21 17:32
大黑蚊子 发表于 2026-4-20 13:43
! C( ?( t' ^/ Y) m. n回首这个帖子
: m+ Y3 d5 B% U9 G) O; m, Y! a如果去年就下手干他1个T的ECC DDR5内存的话...
2 d- w. y/ ~, F/ q$ s* K2 C
我一直以为自己加钱换了512幸好前两年弄了几根1T 2T 4T的nvme还有SATA SSD,就是去年初看来看去没买氦气盘有点后悔。


欢迎光临 爱吱声 (http://129.226.69.186/bbs/) Powered by Discuz! X3.2